GPU · Ampere
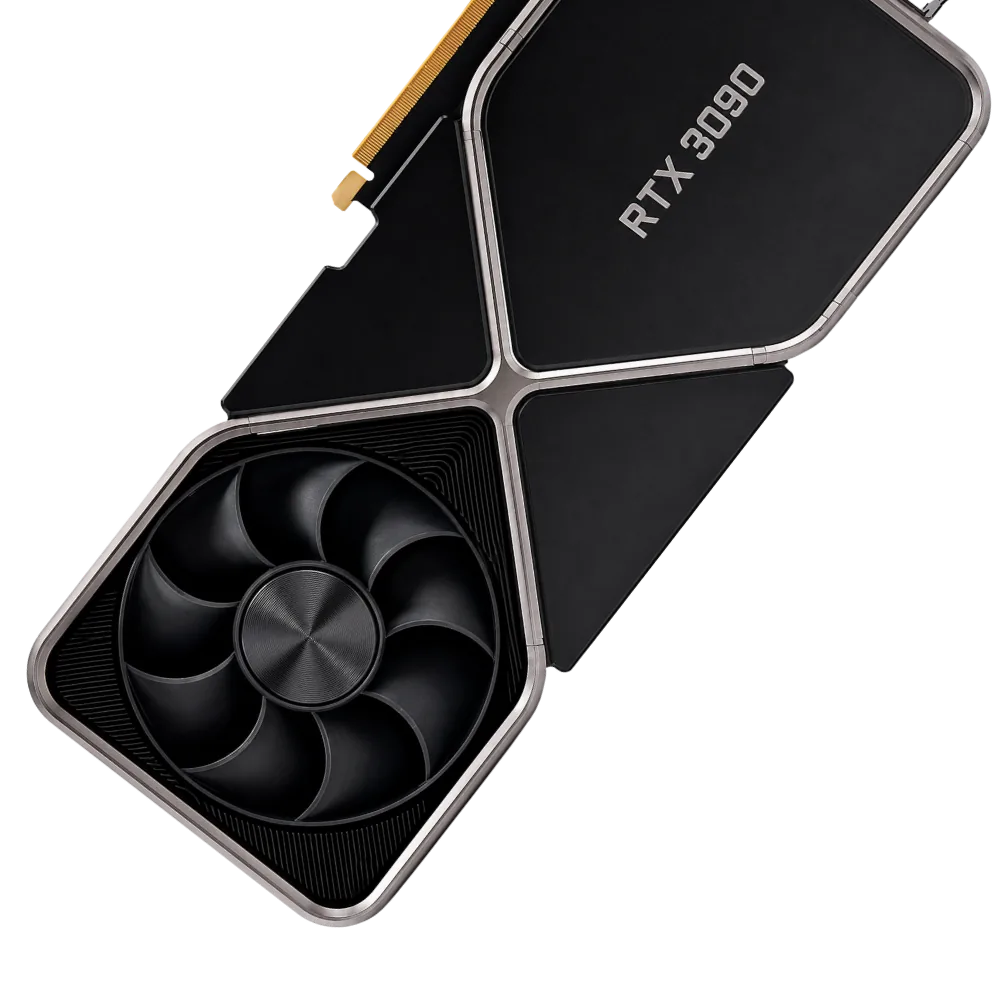
RTX 3090 24GB GPU 서버
24GB VRAM을 가진 Ampere 세대 GPU예요. 7~8B 모델의 16비트 추론과 LoRA 파인튜닝, SDXL 이미지 생성처럼 개인 개발자가 가장 많이 하는 작업을 한 장으로 해결할 수 있어요.
사양
- 아키텍처
- Ampere
- GPU 칩
- GA102
- VRAM
- 24 GB GDDR6X
- Compute Capability
- 8.6
- BF16
- 지원
- FP8 텐서 코어
- 미지원
- 클라우드 게이밍
- 게이밍 저지연 지원
- 시간당 요금
- 230원 / 시간
24GB VRAM으로 다룰 수 있는 모델
컨텍스트 4K, 배치 1 기준으로 VRAM의 85% 안에 들어오는 LLM 크기를 추정했어요. 한계까지 채우면 조금 더 큰 모델도 올라갈 수 있지만, 컨텍스트를 늘릴 여유가 줄어요.
| 작업 | 모델 크기 (추정) |
|---|---|
| 16비트 추론 | 약 8B |
| 8비트 추론 | 약 15B |
| 4비트 추론 | 약 25B |
| QLoRA 파인튜닝 | 약 25B |
| LoRA 파인튜닝 (16비트) | 약 8B |
- 16비트로 여유 있는 모델
- Llama 3.1 8B, Qwen3 8B, EXAONE 3.5 7.8B, Mistral 7B
- 4비트로 여유 있는 모델
- Llama 3.1 8B, Qwen3 8B, EXAONE 3.5 7.8B, Mistral 7B, Gemma 2 9B, Qwen3 14B, Gemma 2 27B
다른 컨텍스트 길이나 파인튜닝 설정은 LLM VRAM 계산기에서 확인하세요.
잘 맞는 작업과 고려할 점
잘 맞아요
- 24GB VRAM으로 8B급 모델을 16비트 그대로 올릴 수 있어요.
- BF16을 지원하고 FlashAttention 2 같은 Ampere 이상 전용 라이브러리를 쓸 수 있어요.
- Stable Diffusion, SDXL, ComfyUI 워크플로에 메모리가 충분해요.
고려하세요
- 30B급 모델은 4비트로 양자화해도 컨텍스트 여유가 빠듯하고, 70B급은 한 장으로 어려워요.
- FP8 텐서 코어가 없어서 FP8 추론은 Ada 이후 세대보다 이점이 적어요.
GPU 서버가 필요할 때